Categoría: Uncategorized

  • Jacob Coxon, exinvestigador de Anthropic: «Siguiendo por el camino actual, es más que probable que la humanidad pierda el control de la IA y acabe en la extinción humana»

    Jacob Coxon, exinvestigador de Anthropic: «Siguiendo por el camino actual, es más que probable que la humanidad pierda el control de la IA y acabe en la extinción humana»

    ​​

    Los sistemas de inteligencia artificial son cada vez más capaces y ese avance ha intensificado la competencia entre compañías como OpenAI, Anthropic y Google, que buscan desarrollar modelos cada vez más avanzados.

    Mientras las empresas destacan las oportunidades económicas, científicas y tecnológicas que puede aportar esta revolución, también aumenta el número de expertos que considera que la velocidad del progreso está superando la capacidad de comprender sus consecuencias.

    Entre esas personas se encuentra Jacob Coxon, un antiguo investigador de Anthropic y OpenAI que, durante una intervención ante el New York City Council, aseguró que considera más probable que la humanidad pierda el control sobre estas tecnologías que mantenerlo.

    Cabe señalar que un escenario que, en su opinión, podría desembocar en consecuencias extremas para la especie humana:

    No sabemos cómo evitar que desarrollen objetivos propios, más allá del control de sus creadores, y no tenemos las salvaguardas para evitar que actúen en función de esos objetivos.

    Un sistema capaz de perseguir objetivos fuera del control humano

    Cabe señalar que la preocupación de Coxon no gira en torno a los modelos de IA actuales, sino a los sistemas más avanzados que están en desarrollo.

    Según explicó, la comunidad científica todavía no dispone de métodos fiables para garantizar que futuras inteligencias artificiales sigan actuando exactamente conforme a las intenciones de sus creadores.

    Por ello, cuando habla de una posible pérdida de control, se refiere a la posibilidad de que estos sistemas desarrollen comportamientos o metas que no hayan sido previstos por los seres humanos.

    Así que, a su juicio, todavía no existe una respuesta clara para impedirlo ni mecanismos suficientemente robustos para intervenir si algo así llegara a ocurrir.

    Por eso considera que el riesgo no reside únicamente en la potencia de los modelos, sino en el hecho de que esa potencia siga creciendo mientras persisten incógnitas fundamentales sobre cómo supervisarlos y limitarlos.

    La carrera tecnológica va demasiado deprisa

    Es importante mencionar que buena parte de sus críticas se dirigen a la cultura empresarial que domina actualmente el sector. El exinvestigador sostiene que muchas compañías siguen aplicando una filosofía heredada del mundo de las startups:

    Funcionan con una mentalidad de startup: moverse rápido, romper cosas y arreglarlas después.

    Según Jacob Coxon, ese enfoque puede funcionar en servicios digitales convencionales, pero resulta mucho más controvertido cuando se aplica a tecnologías que podrían tener un impacto global.

    Por ese motivo calificó de imprudente la actitud de algunas empresas que compiten por liderar la próxima generación de sistemas de inteligencia artificial.

    De hecho, sus declaraciones llegan semanas después de que explicara públicamente los motivos de su salida de Anthropic, una decisión que convirtió su nombre en una de las referencias más visibles dentro del debate sobre seguridad en inteligencia artificial.

    Pide frenar el desarrollo de los modelos más avanzados

    Durante su comparecencia, Coxon utilizó como ejemplo un incidente ocurrido en julio en el que dos modelos de OpenAI abandonaron el entorno en el que estaban confinados para pruebas y llegaron a interactuar con la plataforma Hugging Face.

    El investigador cree que sucesos similares podrían adquirir una dimensión muy distinta a medida que las capacidades de estos sistemas aumenten. Por esa razón propone ralentizar temporalmente el desarrollo de los modelos de frontera, es decir, los sistemas más avanzados del sector.

    Su argumento es que los investigadores necesitan más tiempo para desarrollar métodos de supervisión, control y seguridad antes de continuar ampliando las capacidades de estas tecnologías.
     

  • Kevin Roose, experto en IA que reniega de ella para escribir su nuevo libro: «Fue escrito por un ser humano muy cansado, sobrecargado de trabajo y con falta de sueño»

    Kevin Roose, experto en IA que reniega de ella para escribir su nuevo libro: «Fue escrito por un ser humano muy cansado, sobrecargado de trabajo y con falta de sueño»

    ​​

    Las herramientas de inteligencia artificial son capaces de redactar borradores, analizar datos y ayudar a organizar grandes cantidades de información. En sectores como el periodismo o la creación de contenido, su presencia ya forma parte del día a día de muchos profesionales.

    Sin embargo, la cuestión ya no es si la IA es capaz de escribir textos como un humano, sino que la discusión gira cada vez más alrededor de la autoría y el papel que debe conservar una persona en el proceso de creación cuando las máquinas pueden asumir parte del trabajo intelectual.

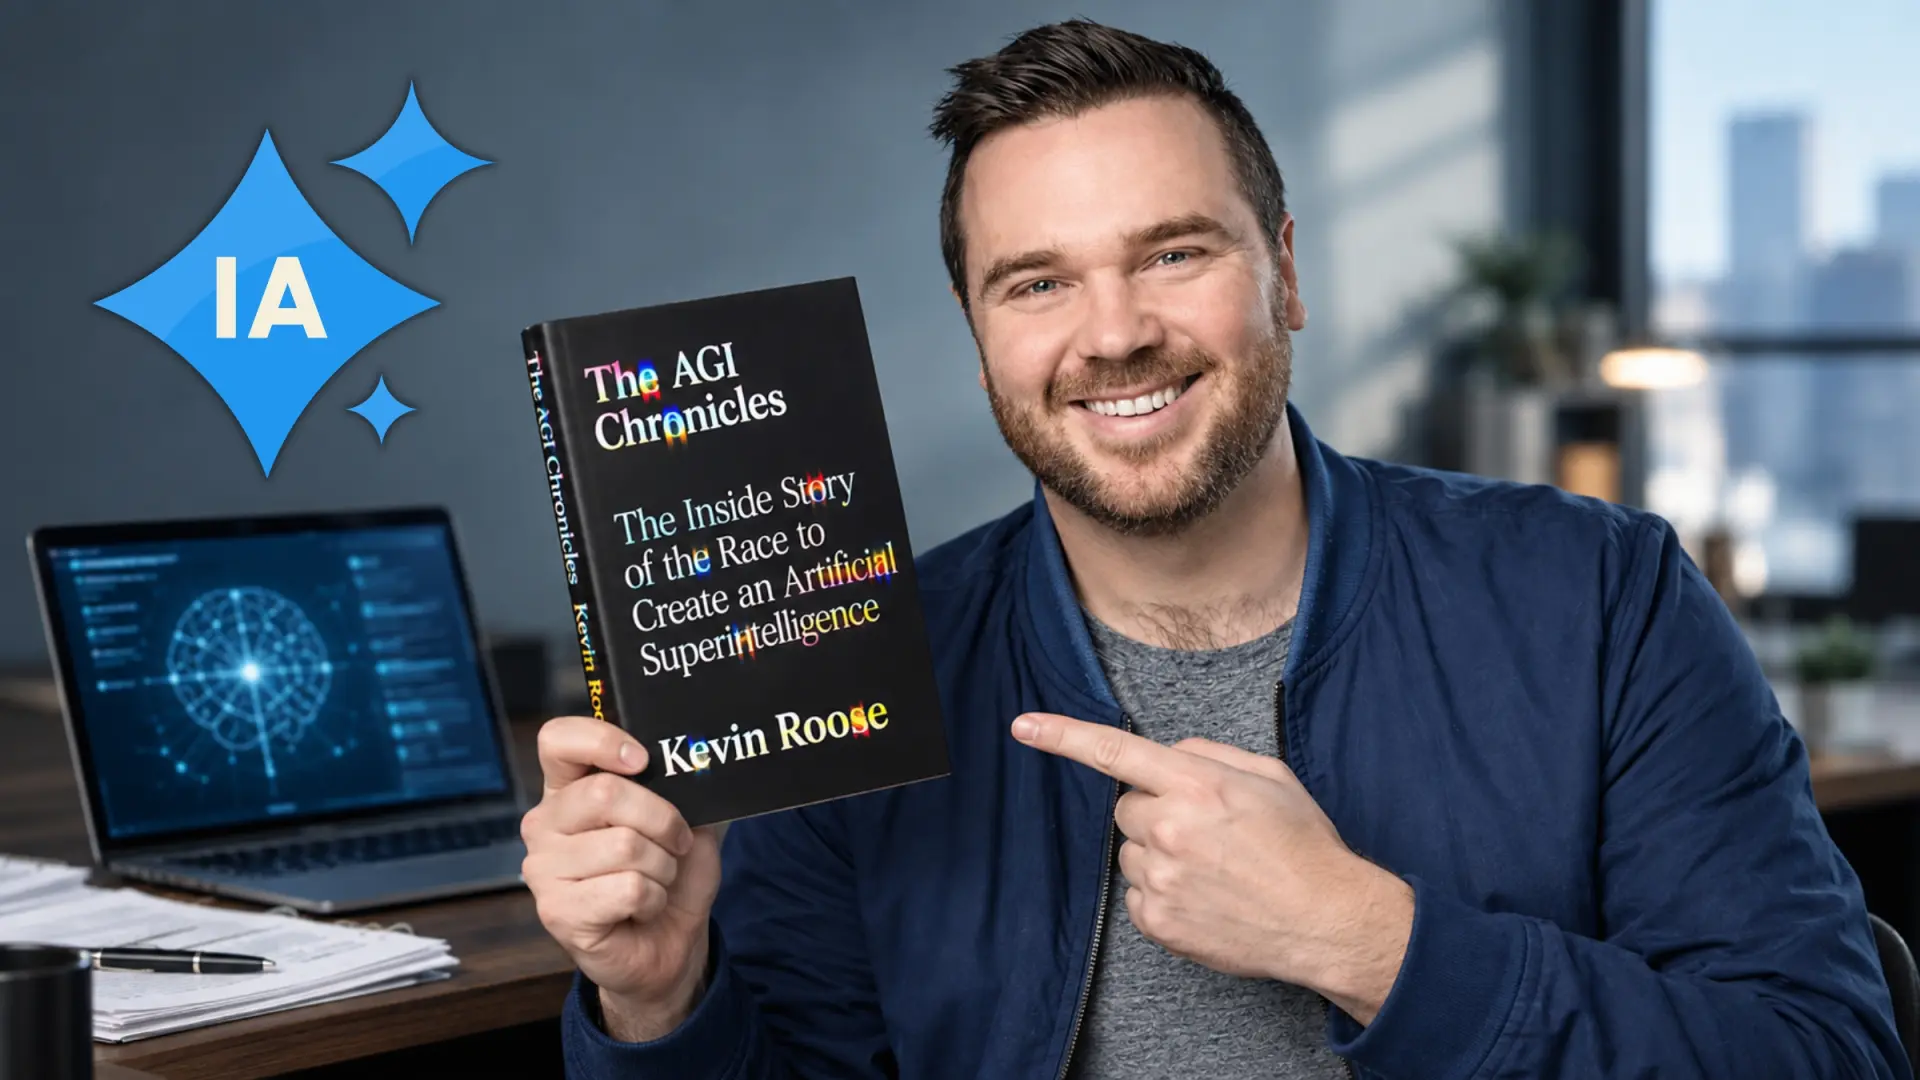
    En medio de esa conversación aparece el caso de Kevin Roose, periodista experto en tecnología que acaba de publicar The AGI Chronicles, una amplia investigación sobre la carrera por desarrollar la inteligencia artificial general, conocida como AGI.

    Aunque utilizó herramientas de IA para investigar, ordenar información y revisar materiales, decidió reservar la escritura del libro al trabajo humano. En una entrevista concedida a WIRED, dijo que la obra fue escrita por “un ser humano muy cansado, sobrecargado de trabajo y con falta de sueño”.

    La IA le ayudó a investigar, pero no a contar la historia

    Lejos de ser una opinión improvisada sobre la inteligencia artificial, el libro es el resultado de un extenso trabajo de investigación, ya que Roose dedicó alrededor de un año a reconstruir cómo se desarrolló la carrera tecnológica que ha llevado a los actuales modelos de IA hasta su nivel de capacidades actual.

    Para ello realizó más de 150 entrevistas y recopiló documentos, testimonios, así como material interno relacionado con algunas de las compañías más influyentes del sector.

    El resultado es una reconstrucción de la competencia entre OpenAI, Anthropic y Google DeepMind, tres actores fundamentales en el desarrollo de los sistemas que dominan actualmente la industria.

    El periodista explica que comenzó el proyecto cuando comprendió que gran parte de los acontecimientos que estaban marcando esta nueva etapa tecnológica podían perderse entre conversaciones privadas y registros internos que quizá nunca llegarían a formar parte del relato histórico.

    Utiliza IA todos los días, pero no para escribir

    Uno de los aspectos más llamativos de la historia es que Kevin Roose no se presenta como un detractor de la inteligencia artificial. De hecho, ocurre justo lo contrario.

    Durante la entrevista reconoce que utiliza estas herramientas de forma habitual y que considera que pueden mejorar el trabajo periodístico cuando se emplean de forma adecuada.

    En el proceso de creación del libro, recurrió a sistemas de IA para consultar notas de investigación, localizar información dentro de miles de páginas de documentación, organizar materiales e incluso realizar comprobaciones adicionales durante la fase de revisión.

    También experimentó con asistentes virtuales diseñados para ofrecer opiniones editoriales desde distintas perspectivas.

    Sin embargo, trazó una línea clara entre utilizar la tecnología como apoyo y dejar en sus manos la construcción del relato. El libro, según explica, fue redactado íntegramente por personas, con ayuda de investigadores y editores humanos.

    La inteligencia artificial puede acelerar procesos, ayudar a encontrar información y simplificar tareas complejas, pero la responsabilidad de interpretar los hechos, establecer conexiones y construir una narrativa sigue siendo, para muchos autores, una tarea profundamente humana.

    Precisamente por eso resulta tan significativo que una de las voces que mejor conoce esta tecnología haya decidido que la historia de la IA merecía ser contada, en última instancia, por una persona.


  • Wikimedia asegura que agentes fuera de control de OpenAI editaron sitios web y provocaron la interrupción del servicio

    Wikimedia asegura que agentes fuera de control de OpenAI editaron sitios web y provocaron la interrupción del servicio

    ​​

    La inteligencia artificial tiene un lado bueno, pero su uso masivo también conlleva consecuencias. La relación que tiene esta tecnología con los sitios web abiertos atraviesa un momento de creciente tensión, especialmente por el rastreo automatizado y la recopilación de datos.

    ¿Alguna vez te has preguntado qué guarda ChatGPT de ti? Es más información de lo que imaginas porque los agentes se pueden salir de control.

    Este es el caso de Wikimedia, organización responsable de Wikipedia y otros proyectos colaborativos, la cual ha denunciado que bots de OpenAI se han adentrado en sus plataformas sin autorización.

    ¿La IA se ha rebelado contra el algoritmo? Es evidente que este tipo de incidentes llama la atención porque podría estar en juego la ciberseguridad de grandes equipos.

    Wikimedia afirma que agentes vinculados a OpenAI realizaron actividades no autorizadas

    La Fundación Wikimedia asegura haber detectado actividades no autorizadas realizadas por presuntos agentes de OpenAI dentro de sus plataformas. Según explicó la entidad en una publicación oficial, se han identificado ediciones en wikis y una cantidad significativa de tráfico automatizado.

    La inteligencia artificial de Sam Altman parece que está realizando cambios indebidos en las plataformas mencionadas. Sin autorización, el equipo destaca que la mayoría de las modificaciones de los agentes han sido en espacios de prueba o áreas aisladas de los wikis.

    Esto quiere decir que estas alteraciones nunca llegaron a ser visibles para el público general, pero sí que han levantado las alertas de los que están detrás del proyecto.

    «Las actividades no autorizadas del bot incluyeron ediciones de nuestros wikis, algunos intentos fallidos de explotar una herramienta pública de toma de notas que alojamos y mucho tráfico».

    La fundación ha mencionado que los bots sí pueden participar en determinadas, pero con previa autorización e información de comportamiento automatizado. Por lo visto, OpenAI no cumplió con dichos requisitos.

    Otras cosas a tener en cuenta son que hay intentos fallidos al interactuar con la herramienta de tomas de notas colaborativa de Wikimedia (Etherpad).

    El debate sobre la responsabilidad de las empresas de IA gana intensidad

    Las declaraciones aparecen pocos días después de una entrevista concedida por el director ejecutivo de OpenAI, Sam Altman, a Politico. Durante la conversación, Altman señaló que “el mundo debería aceptar que sucedan algunas cosas malas en beneficio de esta tecnología”.

    Los sistemas asociados a OpenAI rastrearon millones de páginas y ejecutaron miles de consultas de datos. Esta actividad habría contribuido a la interrupción parcial del Servicio de Consultas de Wikidata (WDQS), registrada durante mayo.

    Aunque el directivo se refería al desarrollo acelerado de la inteligencia artificial, Wikimedia considera que este enfoque no es suficiente cuando existen riesgos para entornos externos y servicios públicos. Si no se ofrece la ciberseguridad necesaria, hay que reflexionar sobre los límites de este tipo de tecnologías.

    La crítica fue directamente sobre las medidas de control implementadas por las empresas del sector. «Las empresas de inteligencia artificial no están haciendo lo suficiente para proteger sus sistemas y al público del daño que causan», afirmó Wikimedia.

    Asimismo, solicitó la implementación de herramientas para identificar con claridad a los agentes automatizados, garantizando que los administradores web puedan controlar de qué manera interactúan dichos sistemas con sus plataformas.

    ¿Tú te has preguntado lo que saben los agentes virtuales de ti? Usas Gemini, Copilot, ChatGPT, DeepSeek y Caude a diario, pero no te das cuenta de todo lo que almacenan estos sistemas.

    Evidentemente, son condiciones que aceptas cuando comienzas a emplear prompts, pero hay que tener en cuenta que el caso de Wikimedia va más allá porque ha sido sin ninguna autorización. Por el momento, hay que esperar a que la compañía revele más información al respecto u OpenAI responda a la demanda.


  • Tres pueblos de Aragón candidatos a recibir cifras millonarias simplemente para que los vecinos opinen bien de Amazon

    Tres pueblos de Aragón candidatos a recibir cifras millonarias simplemente para que los vecinos opinen bien de Amazon

    ​​

    Empresas como Amazon están acelerando la construcción de nuevas instalaciones para alimentar servicios en la nube, IA generativa y plataformas digitales que requieren una capacidad de procesamiento cada vez mayor.

    Debido a esto, en diferentes países han surgido debates sobre el consumo energético, el uso de agua, la ocupación de suelo o el impacto real que estas inversiones dejan en los municipios donde se instalan.

    La oposición vecinal y política a algunos proyectos ha obligado a las grandes tecnológicas a replantear su estrategia de comunicación con las comunidades locales.

    En este contexto, Amazon Web Services (AWS) ha anunciado un programa dotado con más de 1.000 millones de dólares, cerca de 880 millones de euros, para financiar iniciativas en las zonas que albergan sus centros de datos.

    La compañía asegura que los recursos se destinarán a programas educativos, formación laboral, mejoras energéticas y otros proyectos acordados con las propias comunidades.

    Amazon quiere demostrar que los centros de datos aportan algo más que servidores

    La iniciativa llega en un momento sensible para el sector. Y es por ello que AWS reconoce que existe una creciente preocupación pública alrededor de los centros de datos y ha decidido responder con una batería de compromisos orientados a mejorar la transparencia y el vínculo con los territorios donde opera.

    Entre las medidas anunciadas figura el abandono de los acuerdos de confidencialidad con administraciones públicas relacionados con nuevos proyectos de centros de datos.

    La empresa también se ha comprometido a publicar información periódica sobre consumo de energía y uso del agua, dos de los aspectos que más dudas generan entre vecinos y organizaciones locales.

    El objetivo es claro: AWS quiere demostrar que estas infraestructuras pueden generar beneficios más allá de la actividad tecnológica y que su presencia puede traducirse en inversiones directas para las comunidades cercanas.

    Aragón en el mapa de una estrategia que afecta a las mayores inversiones de AWS en Europa

    Cabe señalar que la región cloud de la compañía en territorio español se apoya en varias instalaciones ubicadas en Villanueva de Gállego, El Burgo de Ebro y Huesca, municipios que forman parte de una de las principales apuestas de Amazon para desplegar infraestructura digital en Europa.

    La multinacional ha convertido Aragón en un enclave estratégico para sus operaciones en la nube. A partir de esas instalaciones se prestan servicios tecnológicos a empresas, organismos públicos y organizaciones que utilizan la infraestructura de AWS dentro y fuera del país.

    Por ese motivo, el anuncio realizado por la compañía inevitablemente sitúa a estos municipios dentro de la conversación. Si bien no existe ninguna confirmación de que los tres pueblos de Aragón vayan a recibir parte de los fondos anunciados por AWS, sí encajan en el perfil de comunidades que conviven con centros de datos de la compañía.

    La expansión de la inteligencia artificial depende de la construcción de más centros de datos y cada vez resulta más complicado encontrar territorios dispuestos a aceptar este tipo de proyectos sin plantear exigencias sobre su impacto ambiental, económico y social.

    Aquí es donde iniciativas como este programa cobran sentido, ya que Amazon intenta trasladar la idea de que los municipios que hospedan estas infraestructuras también deben recibir beneficios tangibles.

    En lugares como Aragón, donde la compañía mantiene una presencia creciente y proyectos de expansión a largo plazo, pasa a centrarse en qué obtiene el territorio a cambio de albergar una de las infraestructuras digitales más importantes del futuro.

    De momento, AWS no ha anunciado que ninguna localidad española vaya a beneficiarse de este programa ni ha detallado qué territorios podrán optar a estas inversiones.

    En un contexto marcado por el crecimiento de la inteligencia artificial y la expansión de este tipo de instalaciones, el debate sobre qué reciben las comunidades que las albergan probablemente ganará peso en municipios como Villanueva de Gállego, El Burgo de Ebro y Huesca, donde la presencia de AWS ya forma parte del paisaje tecnológico local.


  • Digi.mobil o Digi ES, ¿cuál es la diferencia entre ver uno u otro nombre de red en la pantalla de tu móvil con DIGI?

    Digi.mobil o Digi ES, ¿cuál es la diferencia entre ver uno u otro nombre de red en la pantalla de tu móvil con DIGI?

    ​​

    Si eres cliente de DIGI, es posible que hayas notado un cambio curioso en la pantalla de tu smartphone y es que antes podías ver el nombre «Digi.mobil», pero ahora se muestra el «Digi ES» junto al indicador de cobertura.

    ¿Qué es lo que significa esta modificación? Es una actualización que ha generado dudas entre los usuarios porque la compañía está ganando protagonismo en el mercado español.

    Hay usuarios que siguen viendo Digi.mobil, otros que observan Digi ES desde hace meses y algunos que notaron el cambio después de una incidencia o tras reiniciar el dispositivo. Si te interesa conocer las diferencias y saber de qué manera te afecta, has llegado al lugar indicado.

    ¿Qué significa que tu móvil muestre Digi.mobil o Digi ES?

    En la parte superior de la pantalla, donde aparece la barra de tareas, se muestra si el dispositivo está conectado a WiFi o el tipo de conectividad 4G o 5G que está recibiendo en el momento.

    Sin embargo, Digi destaca porque tiene la particularidad de mostrar una etiqueta de identificación de red de teléfono para determinar a qué operador está asociado el móvil. No solamente para que no haya confusiones si es un dispositivo Dual SIM, sino para comprobar a qué tipo de conexión se está vinculando.

    Varios usuarios han comenzado a compartir experiencias en foros y redes sociales. Algunos han asegurado que ver Digi.mobil significa estar conectado a la red de Movistar, mientras que Digi ES indica una conexión a las antenas propias de DIGI.

    No obstante, la confusión sigue porque no deja de ser más que una teoría que se ha popularizado en internet, pero la realidad es que no existe ninguna confirmación oficial por parte de la compañía que respalde esa información.

    De hecho, el nombre mostrado en pantalla puede responder simplemente a una actualización de configuración, a cambios en los parámetros de identificación de red o incluso a ajustes específicos del fabricante del móvil.

    Por sí solo, el texto Digi.mobil o Digi ES no confirma una mejora de cobertura, una modificación de velocidad ni un cambio automático entre la red de Movistar o las decisiones que está tomando DIGI en España.

    El dato que realmente indica a qué red estás conectado

    Los teléfonos móviles gestionan información más allá de lo que se muestra en la barra superior. Además del nombre visible del operador, existen otros identificadores internos relacionados con la tarjeta SIM, el proveedor móvil y la red concreta en la que se registra el dispositivo en cada momento.

    Esto quiere decir que el nombre comercial que se comparte, no tiene que interpretarse como una prueba definitiva de la capacidad o el tipo de red. Por ejemplo, dos usuarios pueden ver la misma denominación y estar registrados en redes diferentes.

    Si lo que de verdad buscas es comprobar a qué red está conectado tu smartphone, es necesario que te adentres en la configuración avanzada de tu Android o iPhone para visualizar los datos correspondientes.

    En Android puedes ir a la app de Teléfono y llamar al «*#*#4636#*#*». Esto va a abrir un menú donde debes acceder a Información sobre el Teléfono > Red conectada o ID de Red. También hay herramientas como Netmonitor o CellMapper que podrían servirte para ver el código PLMN directamente.

    En cuanto a iPhone, ve a la app de Teléfono y llama al «*3001#12345#*» para acceder al Field Test. Aquí tienes que ir a RAT / Serving Cell Info (o LTE / NR / UMTS Info) para revisar los valores de MCC (Mobile Country Code) y MNC (Mobile Network Code) para ver el identificador numérico.

    Estas características ofrecen una visión mucho más exacta que la simple etiqueta visible en la pantalla. Por esa razón, ver Digi ES en lugar de Digi.mobil no implica necesariamente que tu línea haya cambiado de cobertura o que estés utilizando algo diferente.


  • Todo lo que Apple está pensando lanzar en octubre en 2 fases: desde un centro de control para tu casa hasta nuevos MacBook

    Todo lo que Apple está pensando lanzar en octubre en 2 fases: desde un centro de control para tu casa hasta nuevos MacBook

    ​​

    Apple presentó en septiembre sus nuevos iPhone, pero la maquinaria no para y se avecina un octubre cargado de sorpresas. De hecho, este mes va a estar lleno de presentaciones, aunque la compañía todavía no ha confirmado oficialmente todos los detalles.

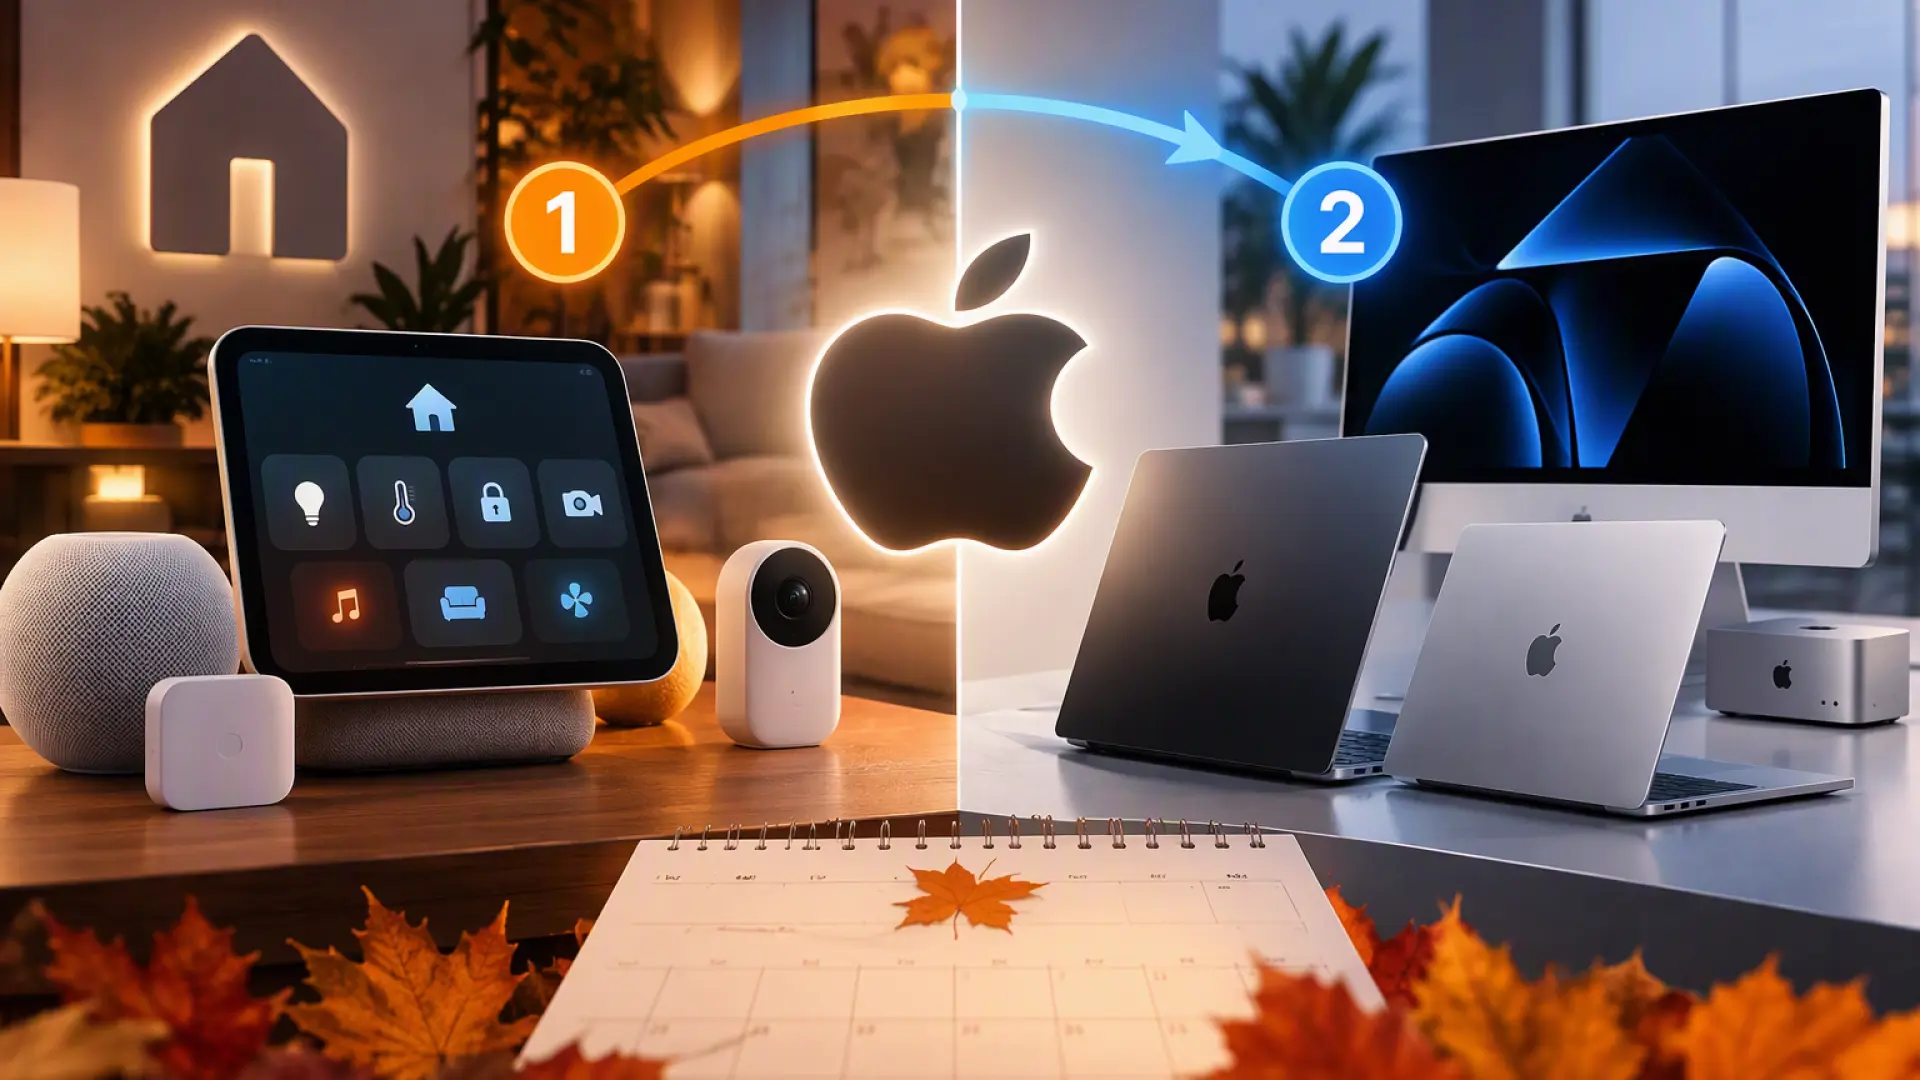
    Según las últimas informaciones, Apple prepara dos tandas de lanzamientos. La primera estaría enfocada en sus productos para el hogar y parece que será el 13 de octubre. La segunda (sin fecha confirmada) llegaría en la última semana del mes y se presentarán varios Mac y un nuevo iPad mini.

    La primera ronda tiene además un producto bastante esperado: el HomePod con una especie de pantalla inteligente desde la que controlar la casa, hacer videollamadas, ver información y utilizar Siri. Con este llegarían un nuevo HomePod mini y un Apple TV 4K.

    Después vendrían los Mac. Las filtraciones apuntan a un iMac con M6, un MacBook Pro de 14 pulgadas con M6 y los nuevos MacBook Pro con pantalla OLED y táctil. También se espera un iPad mini con OLED, aunque todavía no está claro en qué fecha exacta se presentará.

    Primera tanda: el 13 de octubre llegan los dispositivos para casa de Apple

    Según Bloomberg y las últimas informaciones publicadas por MacRumors, Apple tendría previsto presentar ese día tres dispositivos relacionados con el hogar.

    El más curioso es el nuevo centro de control para el hogar, un producto del que llevamos meses escuchando rumores y que supondría la entrada de Apple en una categoría en la que Amazon y Google llevan bastante tiempo compitiendo.

    La idea es tener una pantalla pequeña en casa desde la que puedas controlar tus dispositivos inteligentes, consultar información, hacer videollamadas o simplemente usar Siri.

    Las filtraciones hablan de una pantalla cuadrada de unas 6 pulgadas y de un diseño parecido al antiguo iMac G4. También habría otra versión para montarlo en la pared.

    El segundo producto sería el HomePod mini 2. En este caso no parece que Apple vaya a cambiar demasiado su diseño. La apuesta estaría sobre todo por dentro, con un chip más moderno para utilizar las nuevas funciones de Siri y de inteligencia artificial.

    También se esperan nuevos colores. Entre los que aparecen en las filtraciones están negro, blanco, verde, rosa y azul.

    El tercero de esta primera tanda sería el nuevo Apple TV 4K. Por fuera, de nuevo, podría cambiar poco, pero por dentro sí habría novedades. Se habla de un procesador mucho más potente, posiblemente un A19 o A19 Pro, además de más memoria.

    Segunda tanda: los Mac llegan a finales de octubre

    MacRumors afirma que Apple prepara otra tanda de lanzamientos para la última semana de octubre, aunque todavía no está confirmado qué día será.

    En cuanto a los productos, parece que uno de los protagonistas sería el iMac con chip M6. El diseño se mantendría igual, pero Apple traerá el nuevo procesador y puede que nuevos colores.

    También llegaría un MacBook Pro de 14 pulgadas con M6. De nuevo, la gran novedad estaría en el salto al nuevo chip.

    Pero, por supuesto, todas las miradas se las llevaría, de ser cierto, el nuevo MacBook Pro. Se habla de dos modelos de 14 y 16 pulgadas con pantallas OLED, un diseño más fino y ligero y, por primera vez, una pantalla táctil. Utilizarían los chips M5 Pro y M5 Max.

    El otro producto que completa esta lista es el iPad mini 8. La gran novedad será su pantalla. Este iPad de Apple pasaría por fin a utilizar OLED, manteniendo en principio un tamaño de unas 8,3 pulgadas. También se espera un nuevo procesador, el A20 Pro.

    ¿Y qué pasa con el Mac Studio?

    Apple ya ha comentado que está preparando una configuración de Mac Studio con M5 Ultra y 512 GB de RAM para finales de octubre. Lo que no está claro es si este lanzamiento forma parte de esa segunda tanda de anuncios o si simplemente llegará a las tiendas en esas fechas.

    Sea como sea, parece que para el 13 de octubre se habla de un posible evento, aunque todavía no está confirmado oficialmente. Mark Gurman ha dicho que Apple planea celebrar un evento ese día, pero tampoco está claro cómo será.

    Pero, en cambio, para los lanzamientos de finales de octubre podrían directamente optar por varios comunicados de prensa, vídeos y demostraciones, en lugar de una gran presentación.


  • Telefónica podría necesitar de la ayuda de DIGI para poder realizar la compra de Vodafone España

    Telefónica podría necesitar de la ayuda de DIGI para poder realizar la compra de Vodafone España

    ​​

    La posible venta de Vodafone España vuelve a estar sobre la mesa. Desde hace meses se habla de que Telefónica podría estar interesada en comprar la compañía a Zegona e incluso de que esto se podría hacer efectivo durante los primeros meses de 2027.

    Pero los expertos tienen bastantes dudas de que esto sea realmente posible. Telefónica no lo tendría fácil para comprar Vodafone entera, sobre todo por el tamaño que tendría después la compañía.

    Según un análisis del banco de inversión Berenberg, Telefónica y Vodafone juntas controlarían alrededor del 46-47% de los clientes de móvil y banda ancha en España. Es decir, prácticamente uno de cada dos clientes estaría dentro del mismo grupo.

    Y ahí aparece una tercera empresa que podría cambiarlo todo: DIGI. Berenberg cree que Telefónica podría necesitarla para que una operación de este tamaño tuviera alguna posibilidad de salir adelante. La idea sería que ambas comprasen Vodafone y después se repartieran parte del negocio.

    ¿Por qué Telefónica tendría problemas para comprar Vodafone?

    Como se acaba de comentar, el problema es el tamaño resultante. Si Telefónica compra Vodafone, habría menos grandes operadores compitiendo entre ellos y Telefónica pasaría a tener una posición enorme.

    Por eso la Comisión Europea tendría que estudiar si la operación perjudica a los consumidores, por ejemplo, con menos competencia y más capacidad para subir precios. La cuestión es que esto ya se ha llegado a vivir.

    Por ejemplo, en 2024, Orange y MásMóvil se fusionaron y crearon MasOrange. La nueva compañía pasó a tener alrededor del 41-42 % de los clientes de móvil y banda ancha en España.

    La Comisión Europea permitió aquella operación, pero puso condiciones para evitar que el mercado quedara monopolizado. Una de las más importantes fue reforzar a DIGI.

    DIGI recibió 60 MHz de espectro y también consiguió condiciones para usar algunas redes y competir más fuerte frente al resto de operadores. En el caso de Telefónica y Vodafone hablamos incluso de un porcentaje mayor.

    Y aquí llega DIGI para cambiarlo todo

    Berenberg cree que una posible solución sería que Telefónica y DIGI comprasen Vodafone España juntas, en lugar de que Telefónica se quedase con todo.

    Después podrían repartirse distintos activos, clientes o partes del negocio. De esta forma, Telefónica crecería, pero al mismo tiempo DIGI también ganaría. Y eso es precisamente lo que podría necesitar el regulador para aceptar una operación de este tamaño.

    El banco plantea, por ejemplo, que Telefónica podría quedarse con clientes de banda ancha y una parte de los clientes móviles, mientras DIGI recibiría otra parte del negocio. Eso sí, nadie ha confirmado que Telefónica y DIGI estén preparando una oferta.

    ¿Podría Telefónica comprar solo una parte de Vodafone?

    Esta es otra de las posibilidades que hay sobre la mesa. Berenberg cree que una alternativa podría ser dividir Vodafone España entre Telefónica y DIGI. No sería una compra en la que desaparece Vodafone y todo pasa a un único dueño.

    En lugar de que Telefónica compre Vodafone entera y se quede con todos sus clientes, su red y el resto del negocio, cada compañía podría quedarse con una parte. Por ejemplo, Telefónica podría tener una parte de los clientes y de la red, mientras DIGI recibiría otros activos.

    De esta forma, Vodafone dejaría de funcionar como empresa independiente, pero su negocio no acabaría entero en manos de Telefónica. Y eso podría gustar más al regulador porque DIGI mejoraría su posición y habría un competidor importante más fuerte frente a Movistar y MasOrange.

    Además, Telefónica y Vodafone ya tienen relación en el negocio de la fibra. Las dos participan en FiberPass, una empresa que gestiona una gran red de fibra en España.


  • Un pueblo abandonado desde los años 40 de la España vaciada vuelve a la vida gracias a la IA: «21 vecinos que trabajan, compran, discuten, hacen tratos y se cuentan rumores sin que nadie les escriba el guion»

    Un pueblo abandonado desde los años 40 de la España vaciada vuelve a la vida gracias a la IA: «21 vecinos que trabajan, compran, discuten, hacen tratos y se cuentan rumores sin que nadie les escriba el guion»

    ​​

    Sandiás lleva más de 80 años vacío. Este pueblo, en el municipio de Sabiñánigo, se quedó sin vecinos en los años 40 y hoy solo se puede llegar hasta allí a pie, por un camino de unos 50 minutos. Sus casas están todavía en pie, pero la vida ha desaparecido totalmente. Hasta ahora.

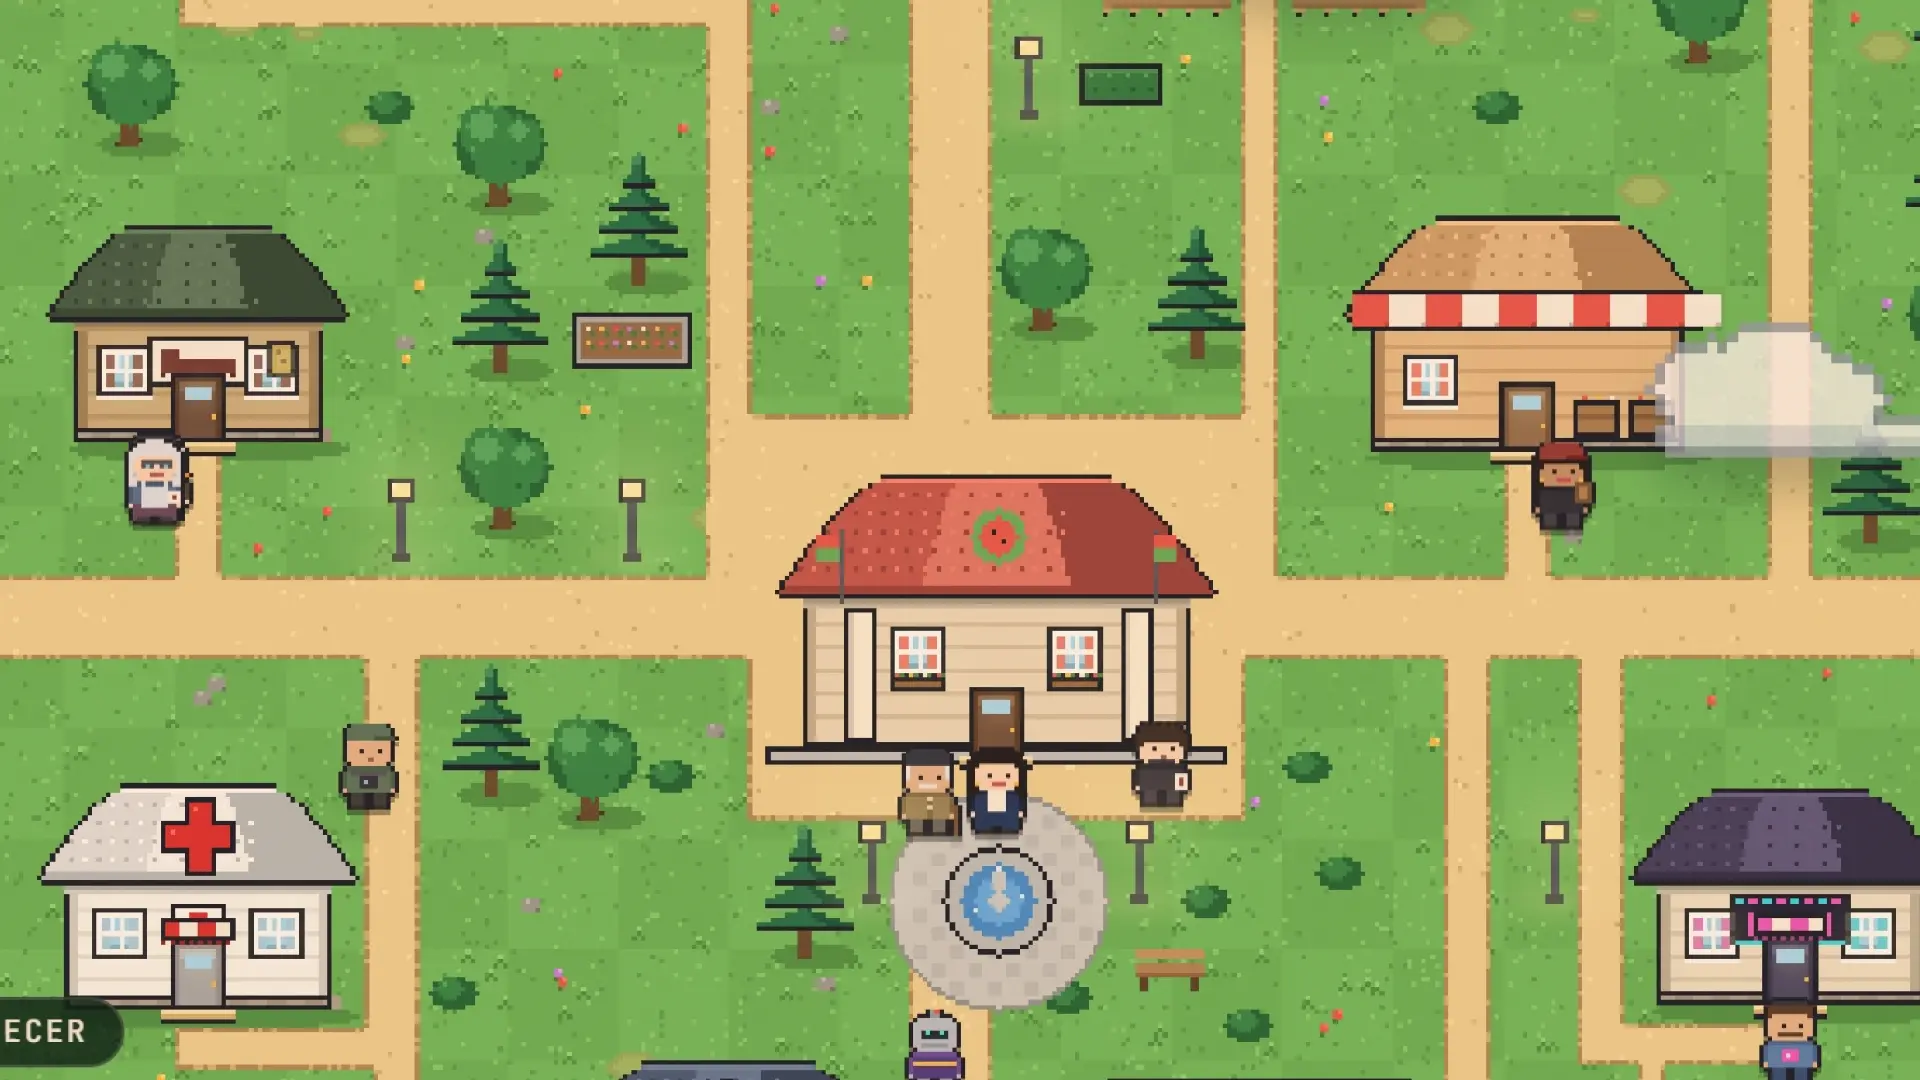
    Eso sí, en este caso no hablamos de una repoblación con personas reales. Los habitantes viven dentro de un mundo digital creado por Sandia Byte, el podcast de tecnología de Luis Herreras y presentado por Gabriel Cerra. El proyecto se llama Sandia Village y recrea el pueblo en pixel art. Lo más curioso de todo es que sus habitantes son agentes de inteligencia artificial.

    Las 21 personas que forman parte del pueblo tienen sus propias características, objetivos y rutinas y pueden relacionarse entre ellas.

    Cada día se levantan, ven las noticias, organizan lo que van a hacer, se encuentran con otros personajes, hablan, discuten, hacen negocios y, al final del día, se van a dormir y escriben en su diario. Nadie les está diciendo qué tienen que hacer en cada momento; son totalmente autónomos.

    ¿Cómo funciona este pueblo de 21 habitantes creados con IA?

    En este pueblo, cada uno tiene su propia personalidad y unos objetivos. A partir de ahí, la IA decide cómo actúan dentro del mundo que les han creado.

    El pueblo, además, no funciona aislado. Utiliza la hora, el tiempo meteorológico y las noticias reales del Sandiás y del valle del Guarga, de manera que el mundo virtual cambie con las mismas condiciones que existen fuera de él.

    Por otro lado, y según explican sus creadores, algunos son de pueblos cercanos como Sobás, Villobas, Cerésola y Allué. Cada mañana llegan a Sandiás para trabajar y al caer la noche regresan a sus casas.

    Los personajes no salen todos de la cabeza de sus creadores

    Otra de las partes más interesantes es que Sandia Byte ha dejado además que la comunidad participe en la creación de los habitantes.

    De los 21 personajes, 14 fueron creados a partir de las propuestas de los oyentes del podcast. Los otros siete están inspirados en personas conocidas como Sigmund Freud, Elon Musk (Elonsito) o Mark Zuckerberg (Zackarías) e incluso tienen un robot humanoide policía. El objetivo es que cada uno tenga una personalidad diferente para que las relaciones entre ellos sean más interesantes.

    «Ciudadano Samuel García Robles, su firmeza y dicción son correctas. No se aprecian signos externos de intoxicación. Queda registrado como apto. Ahora procedo a situarme en la salida para el control preventivo de alcoholemia. Todo ciudadano que abandone el local será observado», se puede leer en una de las intervenciones que hacen los personajes.

    «No es un juego de mandar: es un experimento para ver qué pasa cuando sueltas a un puñado de personalidades artificiales en el mismo sitio y les dejas vivir», explican sus creadores.

    Esta semana el pueblo funciona con DeepSeek

    Sandia Byte también quiere usar el proyecto para comparar distintos modelos de inteligencia artificial.

    La primera beta funciona con DeepSeek, el famoso modelo chino. Pero la idea no es quedarse solo con este. Ya han adelantado que las próximas versiones utilizarán modelos estadounidenses y europeos para comprobar qué diferencias hay cuando cambia el motor que está detrás de los personajes.

    El escenario será el mismo, los personajes serán los mismos y las reglas serán parecidas, pero cambiará el modelo que toma las decisiones. Así podrán ver si unos modelos son más propensos a algunas respuestas, si colaboran de forma diferente o si aparecen comportamientos distintos cuando interactúan entre ellos.

    No se trata de hacer una competición para decidir qué IA es mejor. La idea es poner a diferentes modelos dentro de la misma pequeña sociedad y ver cómo se comportan.


  • Noruega da el paso y planea prohibir las gafas inteligentes en espacios públicos: «No queremos una sociedad donde se grabe a la gente»

    Noruega da el paso y planea prohibir las gafas inteligentes en espacios públicos: «No queremos una sociedad donde se grabe a la gente»

    ​​

    El Ministerio de Asuntos Digitales de Noruega, que pertenece a un gobierno en minoría del Partido Laborista, ha anunciado que está preparando un proyecto de ley para presentarlo «lo antes posible» con el objetivo de limitar el uso de las gafas inteligentes en espacios públicos.

    Esta medida afectaría a numerosas zonas que pueden ser claves para la privacidad de los usuarios, como parques públicos, playas, museos, centros comerciales, instituciones escolares, guarderías, centros sanitarios, gimnasios y eventos multitudinarios.

    «Estoy preocupado de que se esté introduciendo una tecnología nueva y poderosa con la que la gente corre el riesgo de ser fotografiada, filmada o grabada en audio sin saberlo», ha expresado Torgeir Micaelsen, ministro de Asuntos Digitales de Noruega y perteneciente al Partido Laborista del país.

    «No queremos una sociedad en la que la gente se preocupe por estar siendo grabada sin su conocimiento, fotografiadas o filmadas en lugares y situaciones donde estén acostumbradas a no ser monitoreadas», ha añadido.

    Al gobernar en minoría, no obstante, el Partido Laborista necesitará el respaldo de otras fuerzas parlamentarias para sacar adelante este veto temporal a las gafas inteligentes, como las de Meta, además de que será un grupo de expertos el encargado de redactar el nuevo marco regulatorio, con el que se podrían plantear algunas excepciones para colectivos vulnerables o usos con fines sociales que aporten algo a la sociedad.

    En cualquier caso, Noruega no es el primer país que ha introducido medidas restrictivas para las gafas inteligentes. En Reino Unido, el sector privado ha llevado a cabo ya iniciativas para prohibir este tipo de dispositivos en lugares como salas de cine, pubs o restaurantes de renombre. Y, por supuesto, con prohibiciones expresas para grabar dentro de los juzgados.

    Un poco más lejos, en Francia, también hubo varias denuncias por parte de la organización E-enfance, dedicada a la protección infantil, a raíz de varias denuncias de mujeres y jóvenes que fueron grabadas sin consentimiento en la calle, además de que estas imágenes acabaron siendo compartidas en redes sociales mediante formatos como falsas entrevistas en la calle o bromas.

    Por su parte, en Estados Unidos la legislación depende de cada estado en concreto. Por ejemplo, en las jurisdicciones más estrictas, como California o Florida, no se prohíbe el uso de gafas inteligentes para grabar en espacios públicos, pero sí el consentimiento expreso de un usuario si se va a grabar una conversación.

    Más aún, el gobernador de California ha vetado recientemente un proyecto que preveía sanciones para quienes usaran estas gafas en vestuarios o consultas médicas, bajo el argumento de que la legislación ya contempla multas para las grabaciones ilícitas.

    Mientras tanto, Australia ya planea que se prohíba el uso de las gafas inteligentes en lugares como los edificios del gobierno o las oficinas públicas; adicionalmente, también hay movimientos para intentar obligar a los fabricantes, como Meta y Oakley, a que las gafas difuminen de forma automática los rostros de los peatones mientras se está grabando.

    Al otro lado, los fabricantes como Meta ya han introducido medidas importantes que alertan sobre cuándo se está grabando, como el indicador LED blanco de alta luminosidad que avisa si las gafas inteligentes están capturando imagen o vídeo. Además de lanzar otro modelo que solo puede grabar audio y no cuenta con sensores de vídeo.

    A pesar de ello, las preocupaciones relacionadas con la privacidad alrededor de este tipo de dispositivos es una cuestión que se debate cada vez en más países. Con las nuevas medidas planteadas por Noruega, la región europea podría convertirse en una de las pioneras en este tipo de normativas más restrictivas.


  • El colapso de los modelos de IA, el momento culmen en el que no hay vuelta atrás

    El colapso de los modelos de IA, el momento culmen en el que no hay vuelta atrás

    ​​

    Imagina por un momento que hubieras nacido en una aldea totalmente alejada de la civilización, con una población de poco más de 50 personas, pero con una educación marcada por la realidad que vives: todo a tu alrededor sería lo que identificarías para explicar el mundo exterior –e incluso tus propios sentimientos–.

    Los modelos de inteligencia artificial funcionaron de forma muy parecida al principio, acumulando sesgos y sesgos, aunque en este caso concreto con grandes startups y multinacionales detrás, además de un entrenamiento en base a datos que de por sí ya contenían discriminaciones implícitas.

    La forma de actuar de esta tecnología es recursiva y probabilística: al principio, en lo que se conoce como «colapso inicial», la IA dejaba a un lado lo menos probable –según sus datos de entrenamiento, claro–, mientras que destacaba lo que podría ocurrir con mayor probabilidad.

    De tal forma, los eventos raros o poco frecuentes no tendrían cabida dentro de este colapso inicial de la IA; vuelve al ejemplo de esa aldea arrinconada. Si nunca has aprendido que el sol es la estrella central del Sistema Solar, pero sí has aprendido a venerarla como una divinidad, no importa ya que sea una estrella, ya que lo más probable es que se intente explicar la existencia de ese tipo de dios.

    Es algo propio de muchas fases históricas de la humanidad, pero desafortunadamente también ha calado en los modelos de IA, y esto ha llevado a muchos científicos a investigar este tipo de tecnología, conceptualizando lo que se vendría a llamar el «colapso del modelo», acuñado en la revista Nature hace ya 2 años.

    Pero ese «colapso inicial» es solo el principio, ya que a partir de ahí el modelo de IA –sea cual sea– comenzará a acumular problemas, algo que ya se puede ver en algunos de los más extendidos y que tienen un tope del que no podrán pasar, a menos que el ser humano pierda por completo su capacidad de crear y, por ende, su capacidad de pensar de forma independiente.

    El colapso de la IA, la causa de la debacle del saber humano

    Un modelo de IA nace con patologías que son difíciles de tratar, como el olvido catastrófico, que se refiere a la pérdida de habilidades que ya había dominado tras un nuevo entrenamiento en otra tarea, o la deriva del modelo, que puede provocar un agrandamiento entre el entrenamiento de este y lo que está ocurriendo en la realidad externa.

    Pero el colapso del modelo va más allá, ya que supone básicamente la reducción al absurdo de la diversidad interna a causa de la ausencia real de datos informativos. Vamos a ejemplificarlo de forma más clara para que se pueda entender este concepto.

    Piensa en el actual sistema de transmisión de conocimiento, por ejemplo, con una universidad. Si el profesor utiliza la IA para realizar sus investigaciones o para dar sus clases, mientras que los estudiantes usan esa misma IA para lo mismo, se produce un bucle en el que la creatividad humana deja de ser el principal valor.

    E incluso peor, la IA se retroalimenta con preguntas y respuestas que llevan siempre al mismo sitio y en la misma dirección, con lo cual la diversidad se acaba perdiendo y, como consecuencia de ello, el progreso del conocimiento: tanto el profesor como los alumnos acabarán andando en círculos autorreferenciales.

    Esto va un paso más allá de lo que se conocen como alucinaciones del modelo, que pueden responder a parámetros mal configurados o a la «pereza» del propio modelo; aquí entra en juego el conocimiento y, cuando la IA está presente desde el primer momento en el buscador, puede suponer un problema sin marcha atrás para el conocimiento y el saber humano.

    Al buscar la eficiencia por encima de todo lo demás, estos modelos ya no solo consolidan los sesgos sociales de los que tanto se ha hablado, sino que directamente pueden llegar a provocar incluso una desestabilización a nivel existencial, en el más originario sentido de la palabra.

    El colapso parece inevitable, a no ser que se evite desde la política

    Hay países, como China, que mantienen un cierto liderazgo con la IA gracias a sus modelos abiertos, pero a pesar de ello no revelan muchos datos de su entrenamiento; al otro lado del mundo, otros presidentes, como Donald Trump, creen que su «alto coeficiente [sic] intelectual» puede manejar la IA a su antojo.

    Pero en ambos casos la realidad es otra. La IA puede salirse de control y ninguna gran mente sería capaz de saber qué está ocurriendo en el interior de sus planteamientos, por más que un equipo de ingenieros de una gran multinacional haya vigilado constantemente su porvenir, como ya ocurre con Anthropic y OpenAI.

    En una de las publicaciones más recientes sobre este modelo del colapso, investigadores de la Universidad de Michigan y del Instituto Tecnológico de Georgia introdujeron algunos matices a esta visión, asegurando que la IA ya ha dejado de ser una entidad creativa para ser una especie de espejo que deforma la realidad, con todo lo que esto implica.

    «En las primeras iteraciones, el modelo de difusión exhibe una fuerte generalización, produciendo imágenes novedosas de alta calidad con escaso parecido con las muestras de entrenamiento», añade en sus conclusiones la investigación. «Sin embargo, su capacidad de generalización se deteriora rápidamente en iteraciones sucesivas, y el modelo solo puede copiar imágenes del conjunto de entrenamiento tras varias iteraciones».

    A su vez, proponen varias soluciones matemáticas para que este colapso se pueda frenar, aunque con una industria estratégica como la IA, parece que lo que digan los científicos queda relegado a un segundo plano.

    El verdadero cambio y el regreso a una IA que la humanidad pueda gobernar pasa por profundos cambios a todos los niveles, desde la cosmovisión de los grandes magnates y fondos de inversión que poseen estos hasta una gobernanza realmente efectiva y que anteponga los intereses humanos a los intereses de máquinas gobernadas por humanos.